Outils
Outils pour l'infrastructure IA locale
Dimensionnez un modèle, un GPU et un budget avant d'acheter ou de déployer. Chaque résultat montre sa formule, ses entrées et ses hypothèses, et chaque configuration a un lien à partager.
- Chaque résultat s'accompagne de sa formule et des valeurs utilisées.
- Les chiffres des GPU viennent de documents NVIDIA, avec la source à un clic.
- Vos réglages sont dans le lien : vous pouvez envoyer une configuration à un collègue.
Infrastructure IA locale
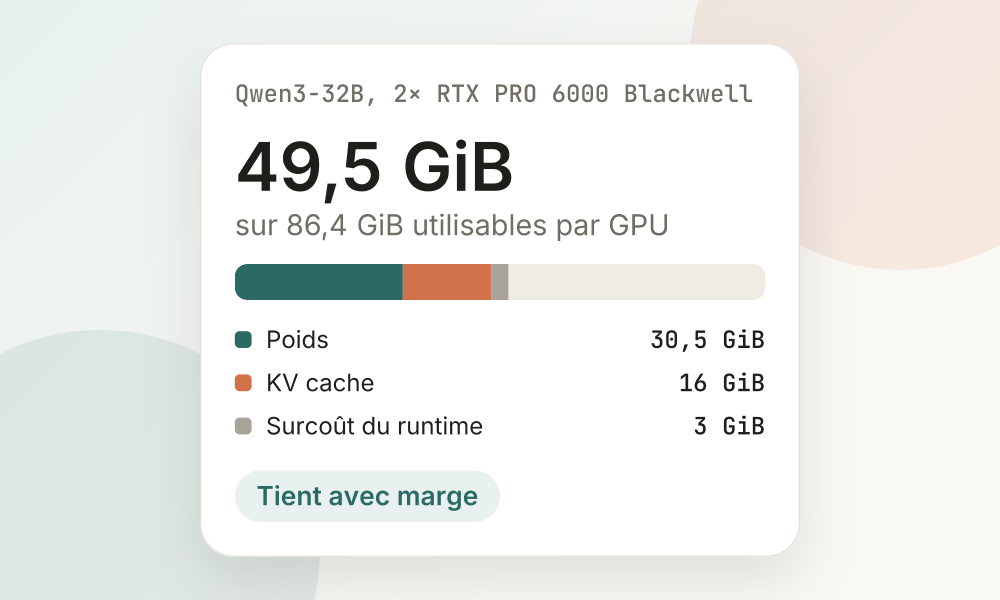
Mémoire du modèle et adéquation au GPU
De combien de mémoire ce modèle a-t-il besoin, et tient-il sur ces GPU ?
Dimensionnez un modèle, un contexte et une configuration de GPU avant de télécharger ou d'acheter quoi que ce soit.
- Vous saisissez
- Taille du modèle, Précision, Longueur du contexte, Concurrence, GPU, Nombre de GPU, Disposition du déploiement, Mémoire utilisable, Surcoût du runtime
- Vous obtenez
- Taille brute des poids, Poids en mémoire, KV cache, Mémoire totale, Verdict, Mémoire restante, Utilisation, Nombre minimal de GPU
- Vous pouvez
- Enregistrer la configuration et la partager par lien
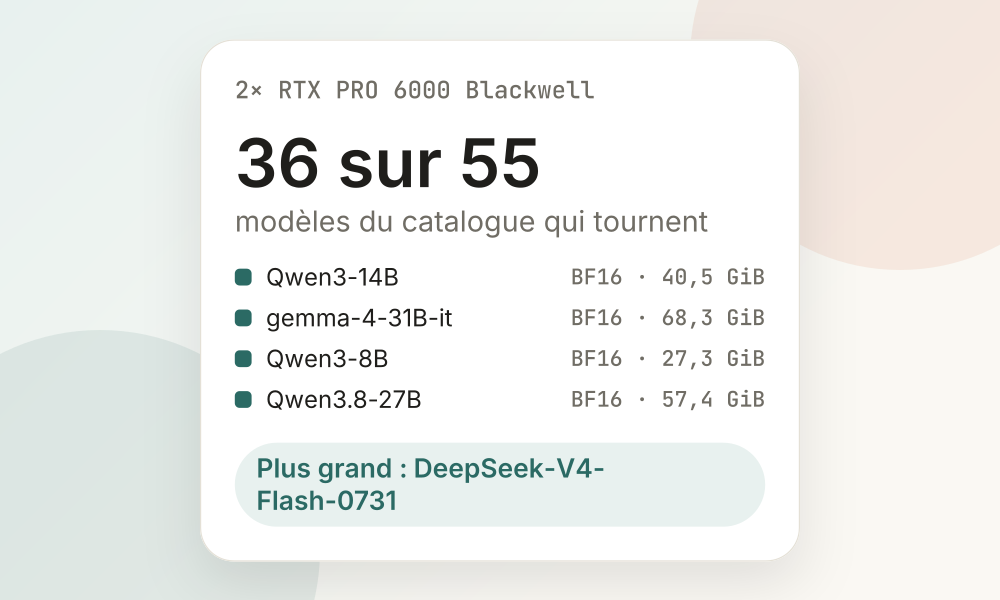
Ce qui tourne sur mon GPU
Quels modèles puis-je faire tourner sur ce GPU ou cette configuration de GPU ?
Partez du matériel dont vous disposez, découvrez les modèles populaires et en tendance qui y tiennent, puis dimensionnez en détail celui qui vous plaît.
- Vous saisissez
- GPU, Nombre de GPU, Longueur du contexte, Concurrence, Mémoire utilisable
- Vous obtenez
- Modèles qui tiennent, Verdict, Mémoire restante
- Vous pouvez
- Enregistrer la configuration et la partager par lien
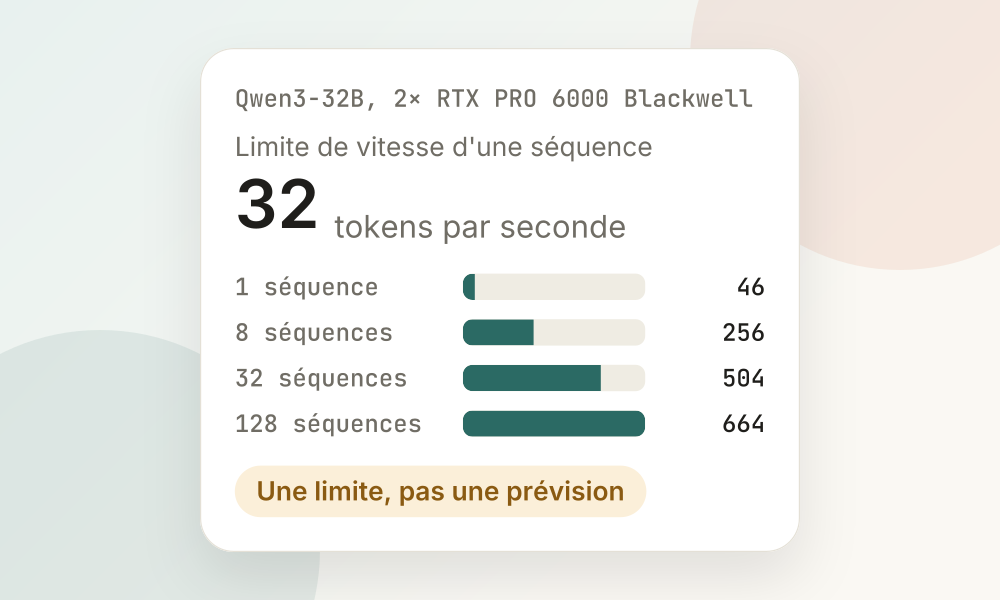
Bande passante mémoire et limites de vitesse
À quelle vitesse ce modèle peut-il au mieux faire du decode sur ce GPU ?
Comprenez pourquoi la bande passante mémoire, et non le calcul, limite le decode d'un LLM, comparez des GPU pour une même configuration et lisez une mesure par rapport à sa limite.
- Vous saisissez
- Taille du modèle, Précision, Longueur du contexte, Concurrence, GPU, Nombre de GPU, Disposition du déploiement, Temps mesuré par token
- Vous obtenez
- Temps de lecture des poids, Étape de decode la plus courte, Limites de vitesse, Batch d'équilibre, Comparaison de GPU
- Vous pouvez
- Enregistrer la configuration et la partager par lien
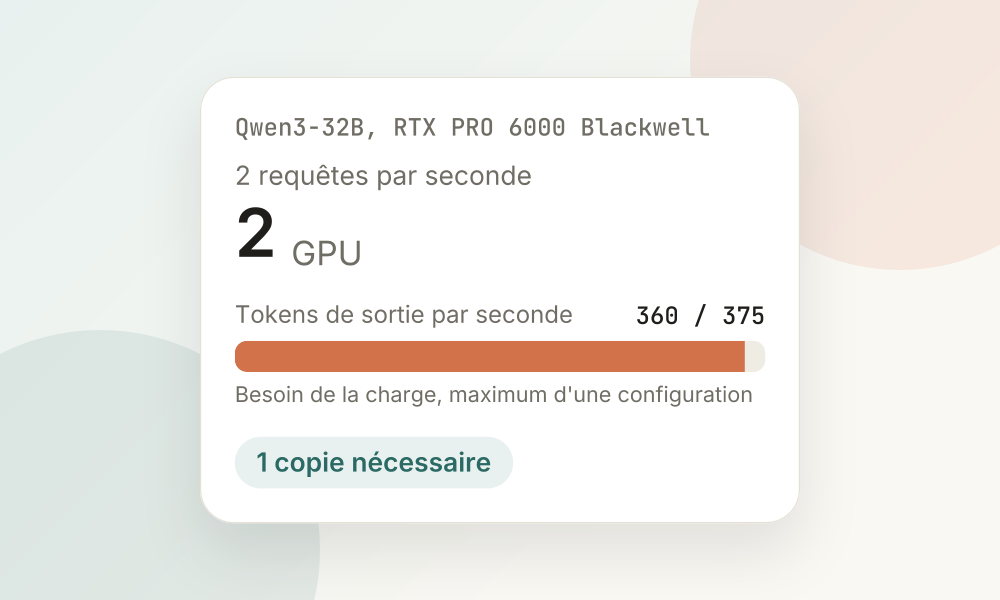
Capacité d'inférence
De combien de GPU cette charge a-t-elle besoin ?
Convertissez des requêtes par seconde et des nombres de tokens en tokens par seconde à servir, voyez ce que le matériel peut faire au maximum et planifiez d'après un throughput que vous avez mesuré.
- Vous saisissez
- Taille du modèle, Précision, Longueur du contexte, Concurrence, GPU, Nombre de GPU, Disposition du déploiement, Charge : requêtes, tokens en entrée et en sortie, Throughput mesuré
- Vous obtenez
- Capacité requise en tokens, Requêtes par seconde et par minute, Nombre de GPU estimé, Requêtes en cours, Répartition prefill et decode
- Vous pouvez
- Enregistrer la configuration et la partager par lien