Tools
Tools für lokale KI-Infrastruktur
Plane Modell, GPU und Budget, bevor du kaufst oder deployst. Jedes Ergebnis zeigt seine Formel, seine Eingaben und seine Annahmen, und jede Konfiguration hat einen Link zum Teilen.
- Jedes Ergebnis kommt mit seiner Formel und den Werten dahinter.
- GPU-Werte stammen aus NVIDIA-Dokumenten, die Quelle ist einen Klick entfernt.
- Deine Einstellungen stecken im Link, so kannst du eine Konfiguration an Kollegen schicken.
Lokale KI-Infrastruktur
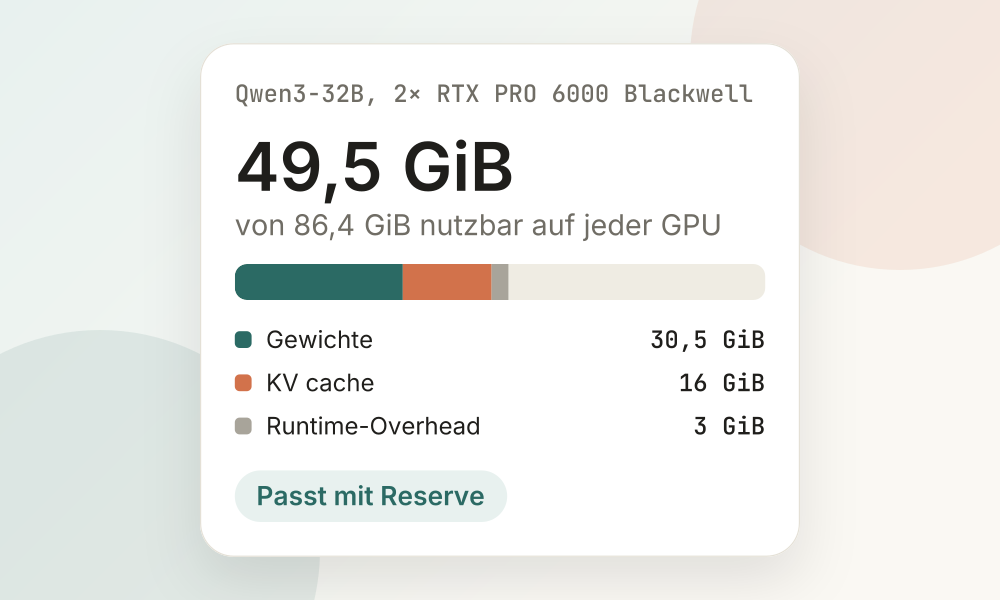
Modellspeicher und GPU-Bedarf
Wie viel Speicher braucht dieses Modell, und passt es auf diese GPUs?
Modell, Kontext und GPU-Setup planen, bevor du etwas herunterlädst oder kaufst.
- Du gibst ein
- Modellgröße, Präzision, Kontextlänge, Gleichzeitigkeit, GPU, GPU-Anzahl, Deployment-Layout, Nutzbarer Speicher, Runtime-Overhead
- Du bekommst
- Rohgröße der Gewichte, Gewichte im Speicher, KV cache, Gesamtspeicher, Passt?, Restspeicher, Auslastung, Minimale GPU-Anzahl
- Du kannst
- Die Konfiguration speichern und als Link teilen
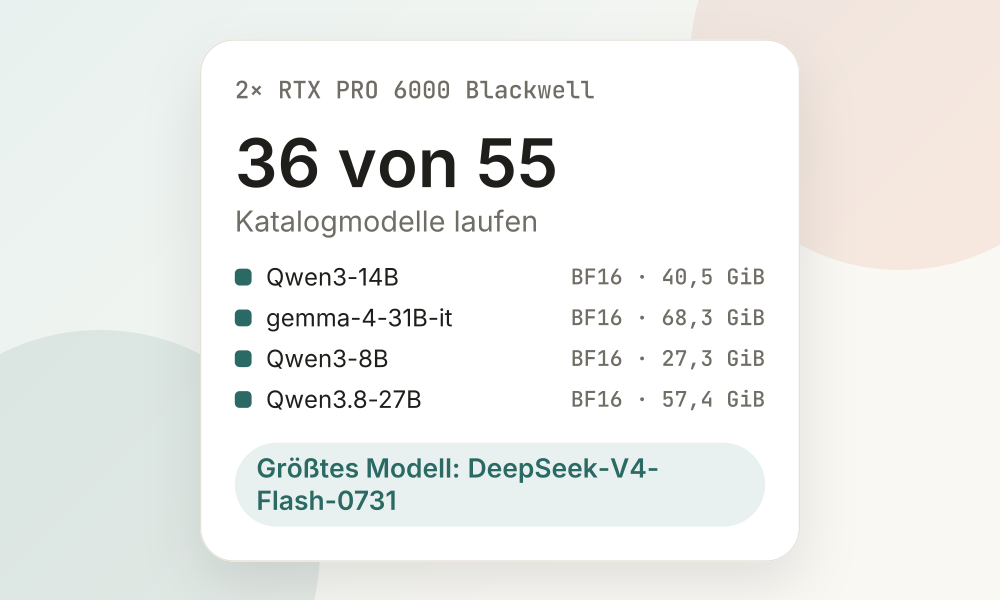
Was läuft auf meiner GPU
Welche Modelle laufen auf dieser GPU oder diesem GPU-Setup?
Von der vorhandenen Hardware ausgehen, beliebte Modelle und Modelle im Trend finden, die darauf passen, und das gewählte Modell danach im Detail dimensionieren.
- Du gibst ein
- GPU, GPU-Anzahl, Kontextlänge, Gleichzeitigkeit, Nutzbarer Speicher
- Du bekommst
- Passende Modelle, Passt?, Restspeicher
- Du kannst
- Die Konfiguration speichern und als Link teilen
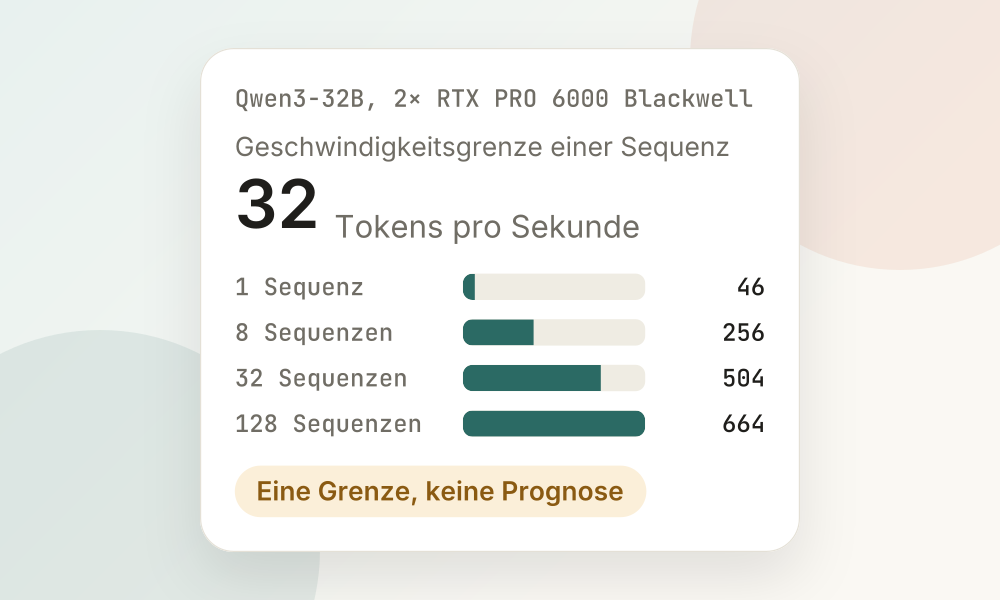
Speicherbandbreite und Geschwindigkeitsgrenzen
Wie schnell kann der Decode dieses Modells auf dieser GPU höchstens laufen?
Sehen, warum Speicherbandbreite und nicht Rechenleistung das Decoding von LLMs begrenzt, GPUs für dasselbe Setup vergleichen und eine Messung an der Grenze einordnen.
- Du gibst ein
- Modellgröße, Präzision, Kontextlänge, Gleichzeitigkeit, GPU, GPU-Anzahl, Deployment-Layout, Gemessene Zeit pro Token
- Du bekommst
- Lesezeit der Gewichte, Kürzester Decode-Schritt, Geschwindigkeitsgrenzen, Break-even-Batch, GPU-Vergleich
- Du kannst
- Die Konfiguration speichern und als Link teilen
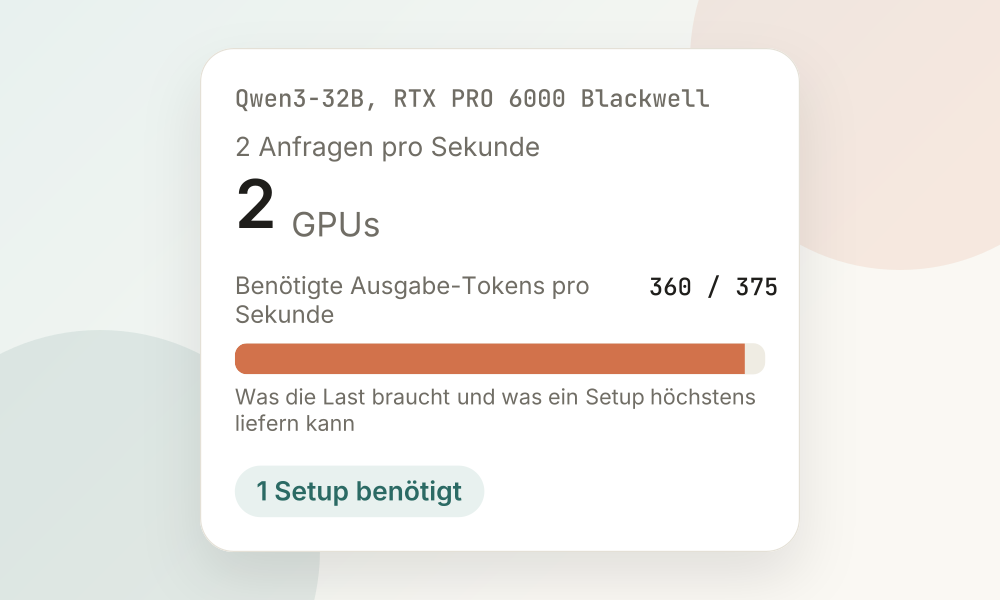
Inferenzkapazität
Wie viele GPUs braucht diese Last?
Anfragen pro Sekunde und Token-Zahlen in die Tokens pro Sekunde umrechnen, die du liefern musst, sehen, was die Hardware höchstens kann, und aus einem selbst gemessenen Throughput planen.
- Du gibst ein
- Modellgröße, Präzision, Kontextlänge, Gleichzeitigkeit, GPU, GPU-Anzahl, Deployment-Layout, Last: Anfragen, Eingabe- und Ausgabe-Tokens, Gemessener Throughput
- Du bekommst
- Benötigte Token-Kapazität, Anfragen pro Sekunde und Minute, Geschätzte GPU-Anzahl, Gleichzeitig laufende Anfragen, Aufteilung in Prefill und Decode
- Du kannst
- Die Konfiguration speichern und als Link teilen