Инструменты
Инструменты для локальной ИИ-инфраструктуры
Прикиньте размер модели, нужный GPU и бюджет до покупки или развертывания. Каждый результат показывает формулу, исходные данные и допущения, а у каждой конфигурации есть ссылка, которой можно поделиться.
- К каждому результату прилагаются формула и значения, на которых он основан.
- Характеристики GPU взяты из документов NVIDIA, источник доступен в один клик.
- Настройки хранятся в ссылке, поэтому конфигурацию можно отправить коллеге.
Локальная ИИ-инфраструктура
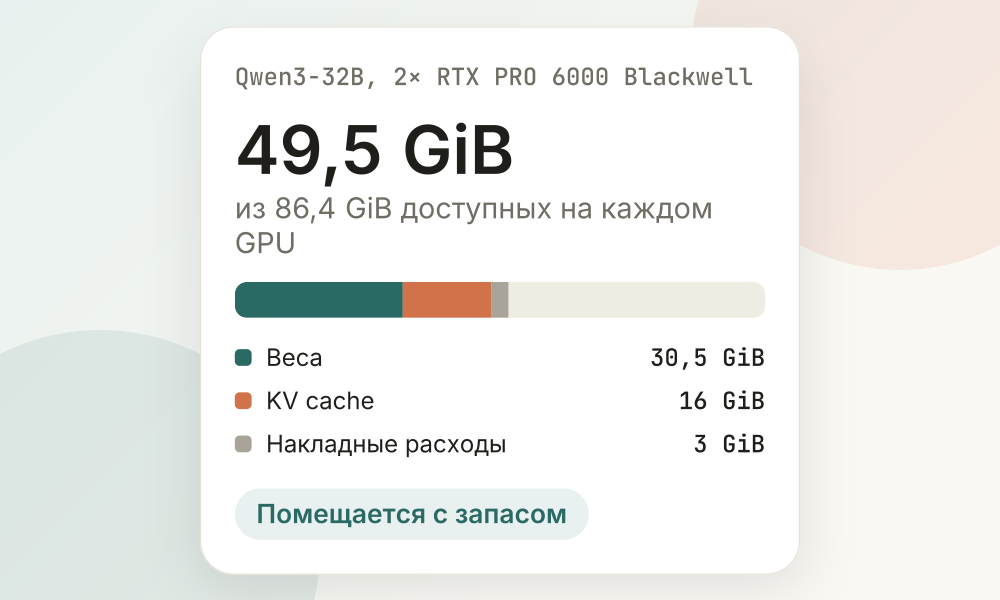
Память модели и размещение на GPU
Сколько памяти нужно этой модели и поместится ли она на эти GPU?
Оцените модель, контекст и конфигурацию GPU до того, как что-то скачивать или покупать.
- Вы вводите
- Размер модели, Точность, Длина контекста, Одновременные запросы, GPU, Число GPU, Схема развертывания, Доступная память, Накладные расходы среды выполнения
- Вы получаете
- Исходный размер весов, Веса в памяти, KV cache, Общий объем памяти, Помещается ли, Оставшаяся память, Загрузка, Минимальное число GPU
- Вы можете
- Сохранить конфигурацию и поделиться ссылкой
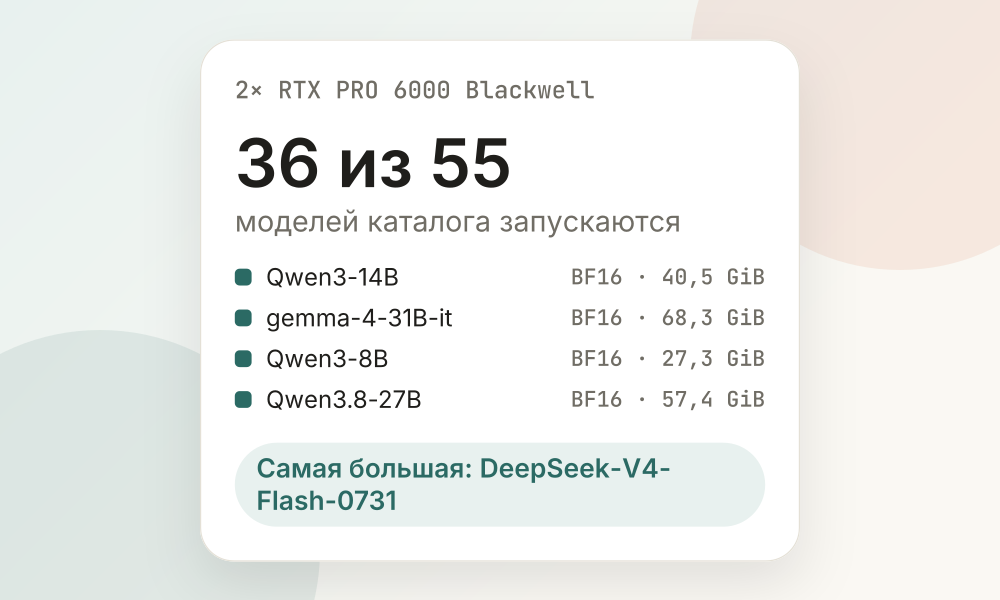
Что запустится на моем GPU
Какие модели можно запустить на этом GPU или этой конфигурации GPU?
Начните с оборудования, которое у вас есть, найдите подходящие популярные модели и модели в тренде, а затем подробно рассчитайте ту, что понравилась.
- Вы вводите
- GPU, Число GPU, Длина контекста, Одновременные запросы, Доступная память
- Вы получаете
- Модели, которые помещаются, Помещается ли, Оставшаяся память
- Вы можете
- Сохранить конфигурацию и поделиться ссылкой
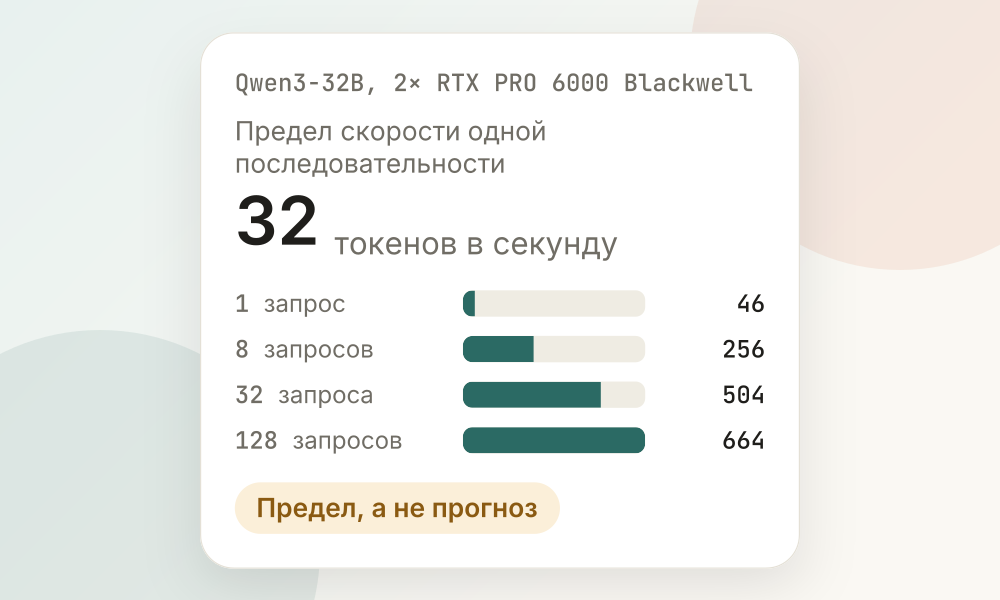
Пропускная способность памяти и пределы скорости
Какова максимальная скорость decode этой модели на этом GPU?
Узнайте, почему скорость decode у LLM ограничена пропускной способностью памяти, а не вычислениями, сравните GPU для одной и той же конфигурации и сопоставьте измерение с пределом.
- Вы вводите
- Размер модели, Точность, Длина контекста, Одновременные запросы, GPU, Число GPU, Схема развертывания, Измеренное время на токен
- Вы получаете
- Время чтения весов, Минимальное время шага decode, Пределы скорости, Пороговый батч, Сравнение GPU
- Вы можете
- Сохранить конфигурацию и поделиться ссылкой
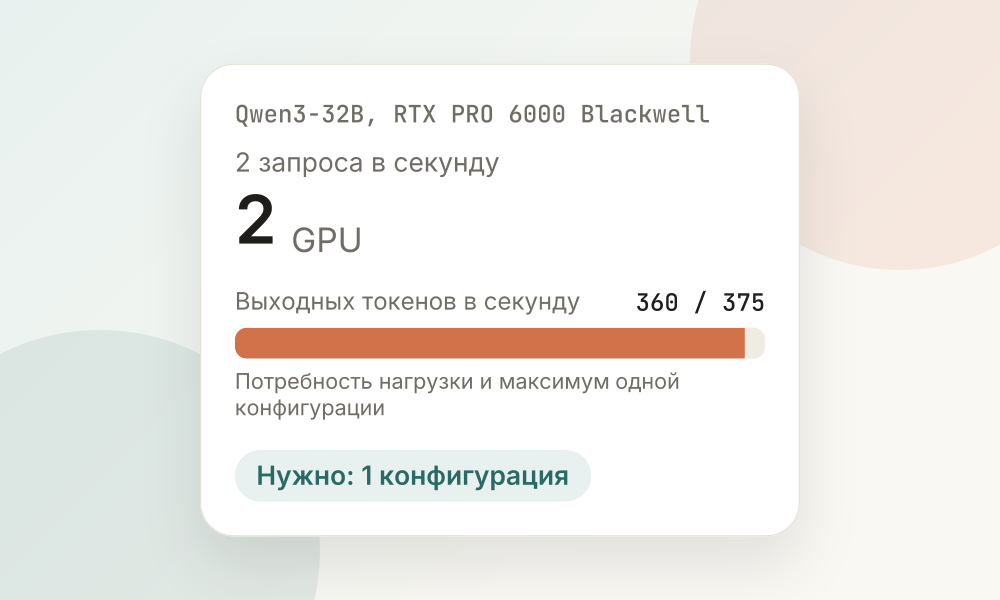
Планирование мощностей инференса
Сколько GPU нужно для этой нагрузки?
Переведите запросы в секунду и число токенов в токены в секунду, которые нужно обслужить, посмотрите, какой максимум дает оборудование, и планируйте по измеренной вами пропускной способности.
- Вы вводите
- Размер модели, Точность, Длина контекста, Одновременные запросы, GPU, Число GPU, Схема развертывания, Нагрузка: запросы, токены на входе и выходе, Измеренная пропускная способность
- Вы получаете
- Нужная производительность, токенов/с, Запросы в секунду и в минуту, Расчетное число GPU, Запросы в обработке, Разделение prefill и decode
- Вы можете
- Сохранить конфигурацию и поделиться ссылкой