Herramientas
Herramientas para infraestructura de IA local
Dimensione un modelo, una GPU y un presupuesto antes de comprar o desplegar. Cada resultado muestra su fórmula, sus entradas y sus supuestos, y cada configuración tiene un enlace para compartir.
- Cada resultado incluye su fórmula y los valores en que se basa.
- Las cifras de GPU proceden de documentos de NVIDIA, con la fuente a un clic.
- Los ajustes se guardan en el enlace, así que puede enviar una configuración a un colega.
Infraestructura de IA local
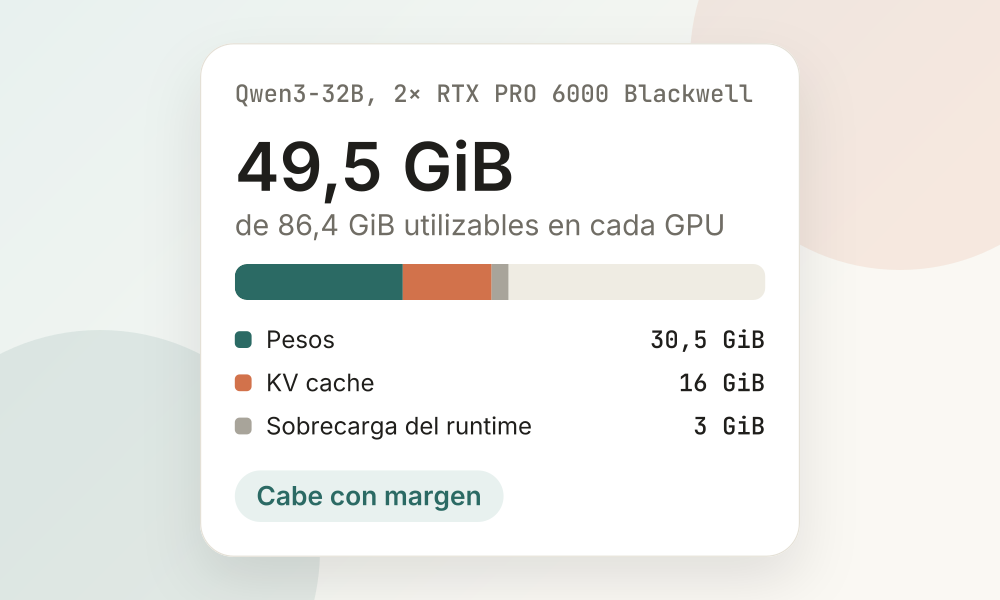
Memoria del modelo y ajuste a la GPU
¿Cuánta memoria necesita este modelo y cabe en estas GPU?
Dimensione un modelo, un contexto y una configuración de GPU antes de descargar o comprar nada.
- Datos de entrada
- Tamaño del modelo, Precisión, Longitud de contexto, Concurrencia, GPU, Número de GPU, Distribución del despliegue, Memoria utilizable, Sobrecarga del runtime
- Resultados
- Tamaño bruto de los pesos, Pesos en memoria, KV cache, Memoria total, Estado de ajuste, Memoria restante, Utilización, Número mínimo de GPU
- También puede
- Guardar la configuración y compartirla con un enlace
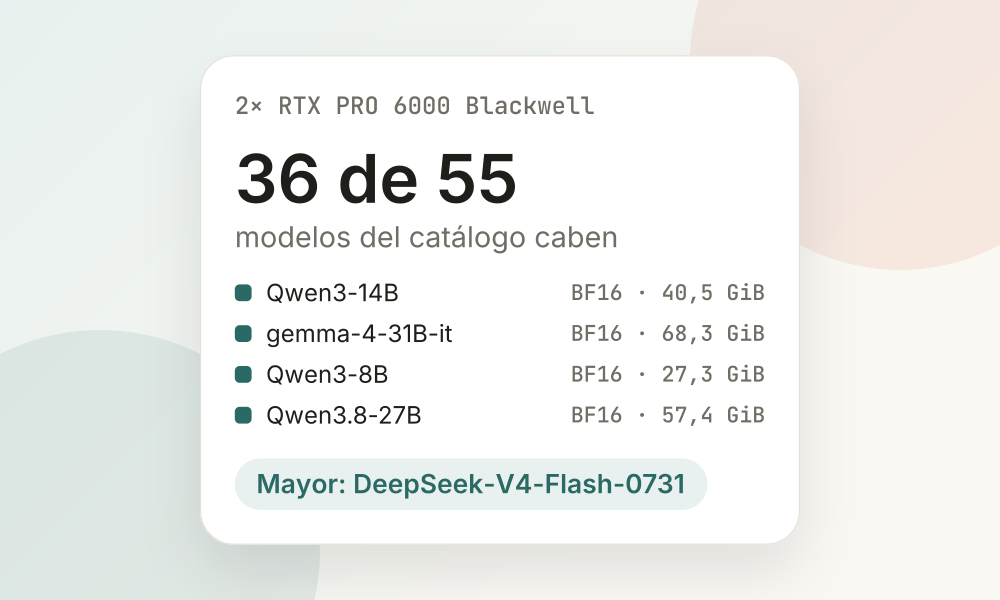
Qué se ejecuta en mi GPU
¿Qué modelos puedo ejecutar en esta GPU o con estas GPU?
Parta del hardware que tiene, descubra los modelos populares y en tendencia que caben en él y dimensione en detalle el que le guste.
- Datos de entrada
- GPU, Número de GPU, Longitud de contexto, Concurrencia, Memoria utilizable
- Resultados
- Modelos que caben, Estado de ajuste, Memoria restante
- También puede
- Guardar la configuración y compartirla con un enlace
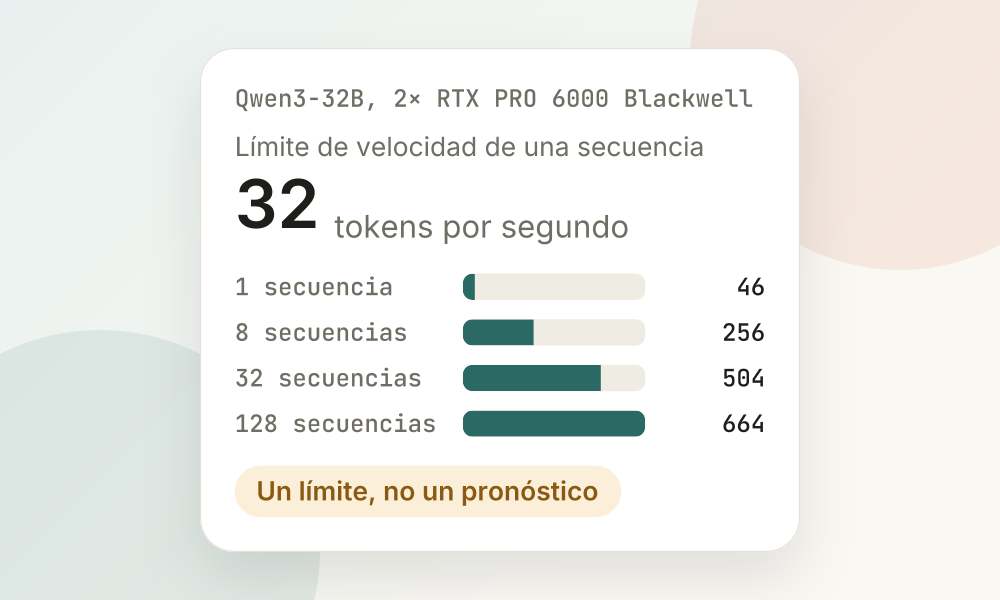
Ancho de banda de memoria y límites de velocidad
¿Qué velocidad máxima de decode alcanza este modelo en esta GPU?
Vea por qué el ancho de banda de memoria, y no el cómputo, limita el decode de un LLM, compare GPU para la misma configuración y lea una medición frente a su límite.
- Datos de entrada
- Tamaño del modelo, Precisión, Longitud de contexto, Concurrencia, GPU, Número de GPU, Distribución del despliegue, Tiempo medido por token
- Resultados
- Tiempo de lectura de los pesos, Paso de decode más corto, Límites de velocidad, Batch de equilibrio, Comparación de GPU
- También puede
- Guardar la configuración y compartirla con un enlace
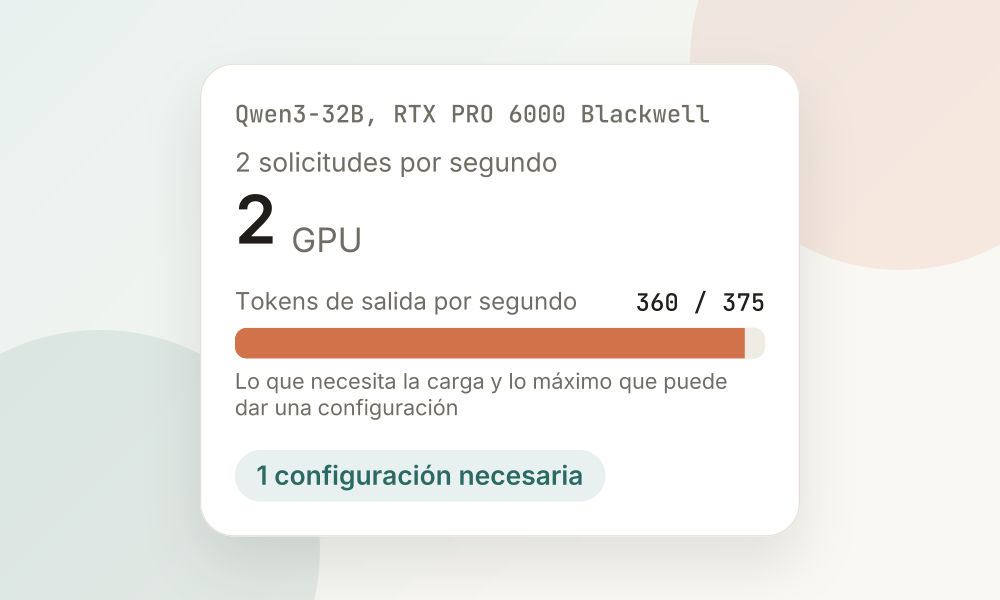
Capacidad de inferencia
¿Cuántas GPU necesita esta carga?
Convierta solicitudes por segundo y recuentos de tokens en los tokens por segundo que hay que atender, vea lo máximo que puede hacer el hardware y planifique con un throughput medido.
- Datos de entrada
- Tamaño del modelo, Precisión, Longitud de contexto, Concurrencia, GPU, Número de GPU, Distribución del despliegue, Carga: solicitudes, tokens de entrada y de salida, Throughput medido
- Resultados
- Capacidad de tokens requerida, Solicitudes por segundo y por minuto, Número estimado de GPU, Solicitudes en curso, Reparto entre prefill y decode
- También puede
- Guardar la configuración y compartirla con un enlace